機械学習におけるデータ表現の最適化手法を徹底解説!
機械学習において、データ表現の最適化は非常に重要なステップです。なぜなら、高品質のデータ表現を行うことで、機械学習モデル内のパフォーマンスを大幅に向上させることができるからです。しかしながら、データ表現の最適化に関する研究は多岐にわたり、初心者にとってはどの手法を選択するか困難に遭遇する場合があります。本稿では、機械学習におけるデータ表現の最適化手法を包括的に解説し、「どの手法が最適か」を明らかにしていきます。

機械学習におけるデータ表現の最適化手法を徹底解説!
機械学習は、データが存在しない限り学習を行うことができません。データは機械学習の基盤であり、データの質と量によって機械学習の性能が左右されます。そこで、本稿では、機械学習におけるデータ表現の最適化手法を徹底的に解説します。
1. データ前処理の重要性
機械学習において、データ前処理は非常に重要なステップです。ノイズ除去や欠損値補完を行うことで、データの質を向上させ、機械学習の性能を改善することができます。また、データ前処理の結果によって、機械学習のアルゴリズムの選択や、パラメーターの調整にも影響を与えるため、注意深く行う必要があります。
2.特徴量エンジニアリング
特徴量エンジニアリングは、機械学習におけるデータ表現の最適化の一環です。特徴量の選択や特徴量の生成を行うことで、機械学習の性能を改善することができます。また、特徴量エンジニアリングにより、データのノイズや偏りを軽減することができます。
3. データの正規化
データの正規化は、機械学習におけるデータ表現の最適化の一環です。スケーリングや標準化を行うことで、データの分布を揃えることができます。また、データの正規化により、機械学習のアルゴリズムの収束速度を改善することができます。
4. データの変換
データの変換は、機械学習におけるデータ表現の最適化の一環です。カテゴリ変換や数値変換を行うことで、データの表現を変更することができます。また、データの変換により、機械学習のモデル複雑度を制御することができます。
5. データの可视化
データの可视化は、機械学習におけるデータ表現の最適化の一環です。図形化やプロットを行うことで、データの分布や関係を視覚的に捉えることができます。また、データの可视化により、機械学習の性能を向上させることができます。
| 方法 | 目的 | 効果 |
|---|---|---|
| データ前処理 | データの質を向上させる | 機械学習の性能を改善 |
| 特徴量エンジニアリング | 特徴量を最適化する | 機械学習の性能を改善 |
| データの正規化 | データの分布を揃える | 機械学習のアルゴリズムの収束速度を改善 |
| データの変換 | データの表現を変更する | 機械学習のモデル複雑度を制御 |
| データの可视化 | データの分布や関係を視覚的に捉える | 機械学習の性能を向上させる |
機械学習の主な3つの手法は?

機械学習の主な3つの手法は监督式学習、半教師あり学習、非監督式学習の三種類に分けられる。
监督式学習
监督式学習は、既知のラベル付きデータを使用してモデルの学習を行う手法である。教師データを用いてモデルをトレーニングし、汎化性能を高めることを目指す。この手法では、正解のラベルが与えられているため、モデルの性能を明確に評価できる利点がある。
- 画像分類
- 自然言語処理
- 音声認識
半教師あり学習
半教師あり学習は、ラベル付きデータとラベル無しデータを組み合わせてモデルの学習を行う手法である。教師データと非教師データを併用することで、モデルの性能を向上させることを目指す。この手法では、ラベル無しデータを使用することで、コスト削減や時間短縮が期待できる。
- 自然言語処理
- 文書分類
- 画像分類
非監督式学習
非監督式学習は、ラベル無しデータを使用してモデルの学習を行う手法である。パターン認識やクラスタリングによって、データの特徴を抽出し、モデルの性能を高めることを目指す。この手法では、ラベル無しデータを使用することで、新しい知見の発見や未知のパターンの発見が期待できる。
- 顧客セグメント分析
- 異常検知
- レコメンデーションシステム
機械学習における最適化とは?

機械学習における最適化とは、モデルやアルゴリズムのパラメータを調整して、 Desireの指標に基づいて最適の性能を実現することを指します。最適化は、機械学習の核心的な技術であり、モデルの精度や効率を最大化するために不可欠な要素です。
目的関数
目的関数とは、最適化の対象となる指標です。損失関数やコスト関数とも呼ばれ、モデルが目指すべき値を算出するために使用されます。例えば、回帰タスクでは Mean Squared Error(MSE)が、分類タスクでは交差エントロピーが目的関数として使用されます。
- Mean Squared Error(MSE):予測値と実際値の差の二乗平均
- 交差エントロピー:分類の結果と実際値の分布の違いを測る指標
- L1 Loss:予測値と実際値の差の絶対値の平均
最適化アルゴリズム
最適化アルゴリズムとは、モデルやアルゴリズムのパラメータを調整するための手法です。勾配降下法やNewton法、Quasi-Newton法が代表的な例です。これらのアルゴリズムを使用することで、目的関数を最小化することができます。
- 勾配降下法:目的関数の勾配を計算し、パラメータを更新する
- Newton法:目的関数のヘッセ行列を計算し、パラメータを更新する
- Quasi-Newton法:ヘッセ行列の近似値を計算し、パラメータを更新する
最適化の挑戦
機械学習における最適化には、様々な挑戦が存在します。局所最適解の問題や過学習の問題が代表的な例です。これらの問題を解くためには、正則化やバッチノーマライゼーションなどの技術を適用する必要があります。
- 局所最適解:目的関数の最小値が複数存在し、lobal最適解に達しない問題
- 過学習:トレーニングデータに過度に適合し、テストデータでは性能が低下する問題
- バッチノーマライゼーション:各バッチの分布を標準化する技術
機械学習におけるGround Truthとは?

機械学習におけるGround Truthとは、教師あり学習や半教師あり学習において、モデルの性能を評価するための基準となる「真の値」や「正しい答え」を指します。Ground Truthは、モデルが予測する値と比較して、モデルがどれくらい正しいかを評価するために使用されます。
Ground Truthの重要性
機械学習におけるGround Truthは非常に重要です。なぜなら、Ground Truthが不正確であると、モデルが予測する値も不正確になるためです。高品質のGround Truthを用意することで、モデルが正しい予測を行うことができます。
- Ground Truthの作成には時間と労力がかかる
- Ground Truthの品質がモデル性能に影響する
- Ground Truthを作成する際には、専門知識が必要
Ground Truthの例
機械学習におけるGround Truthの例として、画像分類タスクでのラベルや、Natural Language Processingでの正しい翻訳などがあります。画像ラベルや翻訳結果などのGround Truthを用意することで、モデルが正しい予測を行うことができます。
- 画像分類タスクでのラベル
- Natural Language Processingでの正しい翻訳
- 音声認識での正しい文字起こし
Ground Truthの問題点
機械学習におけるGround Truthには、問題点もあります。Ground Truthのバイアスやノイズがあると、モデルが不正確になるためです。したがって、Ground Truthを作成する際には、注意しておく必要があります。
- Ground Truthのバイアス
- Ground Truthのノイズ
- Ground Truthの不完全さ
機械学習におけるデータクレンジングとは?
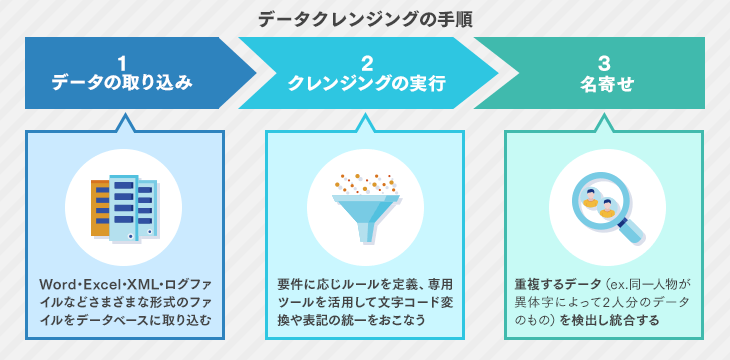
機械学習におけるデータクレンジングとは、機械学習のデータ前処理の一環として、ノイズや異常値を削除し、正規化や変換を行うことで、データの質を向上させ、機械学習モデルの性能を改善することを目的としている。
データクレンジングの重要性
データクレンジングは、機械学習モデルの性能に大きな影響を与える。以下は、データクレンジングの重要性に関するポイントである。
- モデルの汚染防止:ノイズや異常値が含まれるデータを使用すると、モデルの性能が低下する기업。このような状況を防ぐために、データクレンジングが必要である。
- データの信頼性向上:データクレンジングを行うことで、データの信頼性が向上し、モデルの性能が改善する。
- tính効果の向上:データクレンジングを行うことで、モデルの tính効果が向上し、より良い予測結果を得ることができる。
データクレンジングの手法
データクレンジングには、以下のような手法がある。
- データの探索:データの分布や相関関係を調べることで、ノイズや異常値を探し出し、削除する。
- データの正規化:データを統一的なスケールに寄せておくことで、モデルの性能を向上させる。
- データの変換:データをより適切な形式に変換することで、モデルの性能を向上させる。
データクレンジングのツール
データクレンジングには、以下のようなツールがある。
- Pandas:Pythonのデータ分析ライブラリであり、データクレンジングに広く使用される。
- NumPy:Pythonの数値計算ライブラリであり、データクレンジングに使用される。
- OpenRefine:データクレンジング専用のツールであり、データを洗浄、変換、正規化する機能を持つ。
よくある質問
Q1. 機械学習におけるデータ表現の最適化手法とは何か?
機械学習におけるデータ表現の最適化手法とは、機械学習モデルの性能向上を目的として、データの表現形式や構造を最適化するための技術のことです。具体的には、特徴量エンジニアリングや次元削減、データ変換などの手法を用いて、データをよりわかりやすく、分析しやすくすることを目的としています。これらの手法を適切に適用することで、機械学習モデルの性能が向上し、精度の向上や計算コストの削減などを実現することができます。
Q2. 機械学習モデルの性能が低い場合、何が問題になっている可能性がある?
機械学習モデルの性能が低い場合、データの質や特徴量の選び方、モデルのパラメータなどの問題が考えられます。一つの可能性として、データの表現形式が適切でないために、モデルが適切に学習できていない可能性があります。また、過学習や過少な学習などの問題も考えられますこれらの問題を適切に対処することで、機械学習モデルの性能を向上させることができます。
Q3. データ表現の最適化手法は、どのような場合に有効なのか?
データ表現の最適化手法は、大規模データや高次元データを対象とした機械学習において特に有効です。また、ノイズの多いデータや不均衡データを対象とした場合にも効果があります。これらの場合、適切なデータ表現の最適化手法を適用することで、機械学習モデルの性能を向上させ、精度の向上や計算コストの削減などを実現することができます。
Q4. データ表現の最適化手法を適用する上での注意点は何か?
データ表現の最適化手法を適用する上での注意点として、データの特性やモデルの性質を適切に理解することが重要です。また、過剰適合や過少な適合を避けるために、ハイパーパラメーターのチューニングやスバリデーションなどの手法を適用する必要があります。これらの点を適切に注意することで、データ表現の最適化手法を効果的に適用することができます。
Si quieres conocer otros artículos parecidos a 機械学習におけるデータ表現の最適化手法を徹底解説! puedes visitar la categoría Puroguramingu.